Consensus d'experts sans entraînement contre MoE patch-wise appris
Trois experts BraTS, leurs vetos et leurs votes, face à un gate appris dans le réseau — jugés sur les métriques officielles BraTS-2023
BraTS 2023 GLI · nnU-Net v2 · MedNeXt-B · 3 experts × 5 folds (n = 1 196) · métriques officielles lesion-wise, régime clean
Guillaume Cassez (ORCID 0009-0007-0987-3931) · Stanislas Larnier (IdHAL stanislas-larnier) · Recherche indépendante 2026
Résumé
Trois experts complémentaires — Baseline (CE+Dice), DistMap (carte de distance signée en tâche auxiliaire) et Kervadec (loss boundary) — sont entraînés sur BraTS 2023 GLI en validation croisée 5 folds (1 196 patients, MedNeXt-B via nnU-Net v2, 300 epochs). Ce travail compare deux familles de combinaisons sous les métriques officielles du challenge (Dice et HD95 lesion-wise, nettoyage de composantes 1000/250/500, moyenne des trois régions par patient) : des opérateurs déterministes SANS entraînement — vetos de composantes connexes à deux et trois experts, votes majoritaires — et un mélange d'experts patch-wise (MoE V3) dont le gate est appris DANS le réseau pendant l'entraînement.
Le consensus K∩B (Kervadec filtré par le veto de Baseline) termine en tête du tableau des bras : Dice 0,8877 et HD95 18,86 mm au fold 0, avec deux intervalles de confiance excluant zéro. Le vote majoritaire à trois experts porte le seul gain qui survive à la correction de Holm sur la famille exploratoire : +0,0022 Dice, p_Holm = 9,0×10⁻⁸.
Le MoE patch-wise, lui, gagne : +0,0057 Dice en moyenne sur la CV 5 folds (écart-type 0,0029), dans le même sens sur les cinq folds (p de 3,1×10⁻⁴ à 1,0×10⁻¹²) et sur les trois graines du fold 0 (+0,0041 / +0,0048 / +0,0039, étendue 0,0009). L'intervalle de confiance à 95 % exclut zéro sur les folds 1 et 3 et le chevauche sur 0, 2 et 4 ; le HD95 baisse sur quatre folds, jusqu'à −3,07 mm. Le gain reste modeste patient par patient : le gate bat tous les opérateurs sans entraînement sur 92 des 240 cas du fold 0 (38,3 %) et descend sous les trois experts sur 36 (15,0 %), proportion reproduite sur population disjointe (51,5 % de victoires, 14,2 % de casses au fold 1). Un gate appris livre donc un progrès reproductible au niveau de la population — près du triple de celui du vote majoritaire — sans garantir le résultat d'aucun patient.
Contexte
Les papiers 1 et 2 ont établi que les deux losses auxiliaires — carte de distance et loss boundary — ne battent pas la baseline seules sur les métriques officielles, mais qu'elles se placent aux deux bouts de l'axe rappel/précision : DistMap rappelle plus, Kervadec précise plus. Cette complémentarité pose la question de la combinaison : comment assembler trois experts qui se trompent différemment ?
Deux réponses s'affrontent. La première, déterministe et sans entraînement : des vetos de composantes connexes (une composante d'un expert n'est conservée que si un autre expert la corrobore) et des votes voxel à voxel. La seconde, apprise : un mélange d'experts patch-wise dont le gate décide, région par région, quel expert écouter. Ce papier les mesure avec le même instrument — la capsule officielle des métriques BraTS-2023 — et la même correction de multiplicité.
Méthodes
Experts : Baseline (CE+Dice), DistMap (λ = 0,1), Kervadec (λ = 0,05) — socle commun MedNeXt-B via nnU-Net v2, 300 epochs, entraînés sur les 5 folds (n = 1 196 au total). MoE patch-wise V3 : gate dans le réseau, 300 epochs, validation croisée 5 folds complète (n = 239 par fold, 1 195 patients au total) et 3 graines au fold 0 (42, 1337, 2024).
Opérateurs sans entraînement : vetos de composantes connexes à deux experts (K∩B, B∩K, D∩K, K∩D) et à trois experts, votes union/majorité/unanimité — appliqués sur les prédictions de validation, puis nettoyage de composantes du régime officiel « clean ». Métrique : Dice et HD95 lesion-wise officiels, moyenne des trois régions (WT, TC, ET) par patient, tests appariés avec correction de Holm.
Résultats
Au fold 0 (240 cas), le consensus K∩B domine le tableau des opérateurs sans entraînement : Dice 0,8877, HD95 18,86 mm, les deux intervalles de confiance excluant zéro. Le vote majoritaire y ajoute +0,0022 Dice (p_Holm = 9,0×10⁻⁸) — un opérateur qui n'a rien appris.
Le MoE V3 gagne +0,0057 Dice en moyenne sur la CV 5 folds (écart-type 0,0029) et dans le MÊME sens sur les cinq : +0,0041 (p = 3,1×10⁻⁴), +0,0082 (p = 1,8×10⁻¹²), +0,0045 (p = 5,2×10⁻⁷), +0,0092 (p = 2,6×10⁻⁹), +0,0025 (p = 1,0×10⁻¹²), le HD95 baissant sur quatre folds (jusqu'à −3,07 mm). L'intervalle de confiance à 95 % exclut zéro sur les folds 1 et 3, et le chevauche sur 0, 2 et 4. Sur trois graines du fold 0 le gain ne change pas de signe (+0,0041 / +0,0048 / +0,0039, étendue 0,0009) : il ne dépend ni du fold d'entraînement ni de l'initialisation.
Le gain moyen reste petit à l'échelle d'un patient : au fold 0 le MoE bat tous les bras déterministes sur 92 cas sur 240 (38,3 %) et descend sous les trois experts sur 36 (15,0 %) ; au fold 1, population disjointe, il bat les trois experts sur 123 cas sur 239 (51,5 %) et casse sur 34 (14,2 %). Le verdict est double : l'entraînement du gate achète un progrès reproductible au niveau de la population — là où le meilleur opérateur sans paramètre s'arrête à +0,0022 — mais il n'est pas une garantie individuelle, et un expert seul reste devant sur près de la moitié des cas.
Cas sélectionnés au viewer
Six cas illustrent ces résultats dans le viewer 3D, choisis par classement automatique sur les métriques officielles (chaque lien ouvre le viewer sur le patient et le modèle du cas). Chaque cas porte le pourcentage de la population qu'il représente.
Cliquez la figure pour ouvrir cette vue exacte dans le viewer 3D
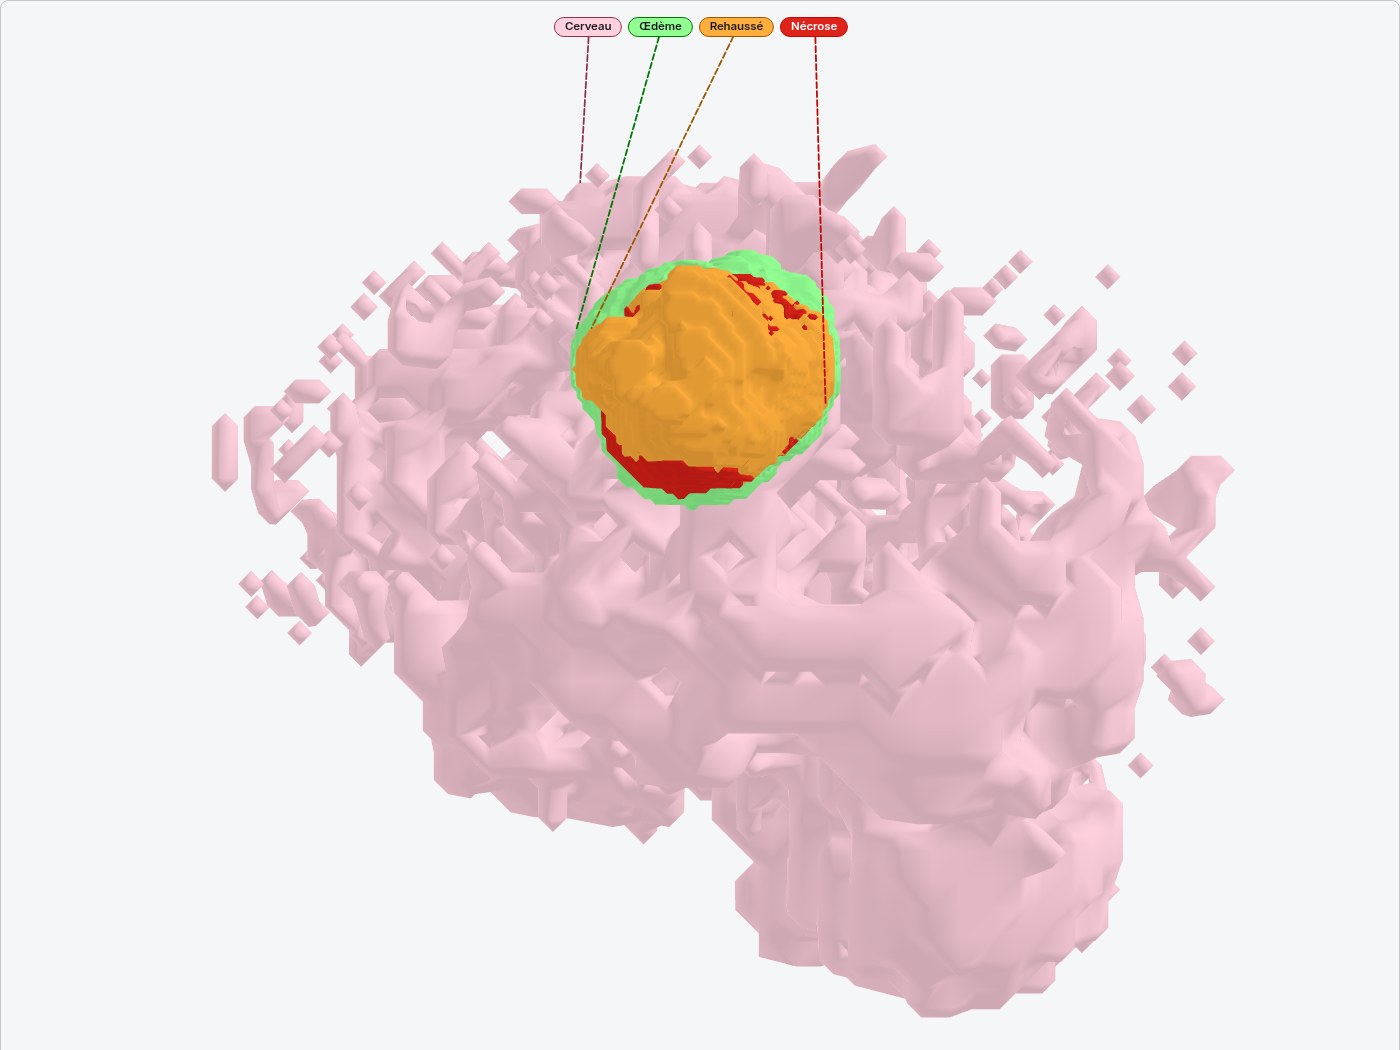
Le gate passe devant le vote majoritaire et les trois experts — 92/240 cas (38,3 %) au fold 0.
Le gate perd le rehaussement et la nécrose : 0,317 quand DistMap tient 0,507 — 36/240 cas (15,0 %).
Population disjointe : 123/239 cas (51,5 %) voient le gate battre les trois experts.
Le veto de composantes passe devant ses deux experts — 3/1196 cas, l'exception qui survit.
Le veto retire à DistMap (0,98) une composante légitime : chute à 0,82.
DistMap à 0,515 contre 0,429 au gate — 116/239 cas (48,5 %) du fold 1.
Travaux associés
L'expert DistMap : loss auxiliaire par carte de distance signée et filtre CC-consensus.
L'expert Kervadec : la loss boundary transposée en 3D, miroir précision de DistMap.
Explorer les segmentations, les consensus et les cartes d'interprétation (Grad-CAM, certitude, accord).
Manuscrit v0.13 publié le 22/09/2026, accès ouvert · DOI 10.5281/zenodo.22776410 (résout vers la dernière version) · archive citable avec code, données et figures.
Bundle de reproductibilité : manuscrits EN+FR, code, JSON de résultats exacts, figures, tables et provenance des données — miroir vivant de l'archive Zenodo.